FCR-PO:学习语言模型推理中值得重试的位置
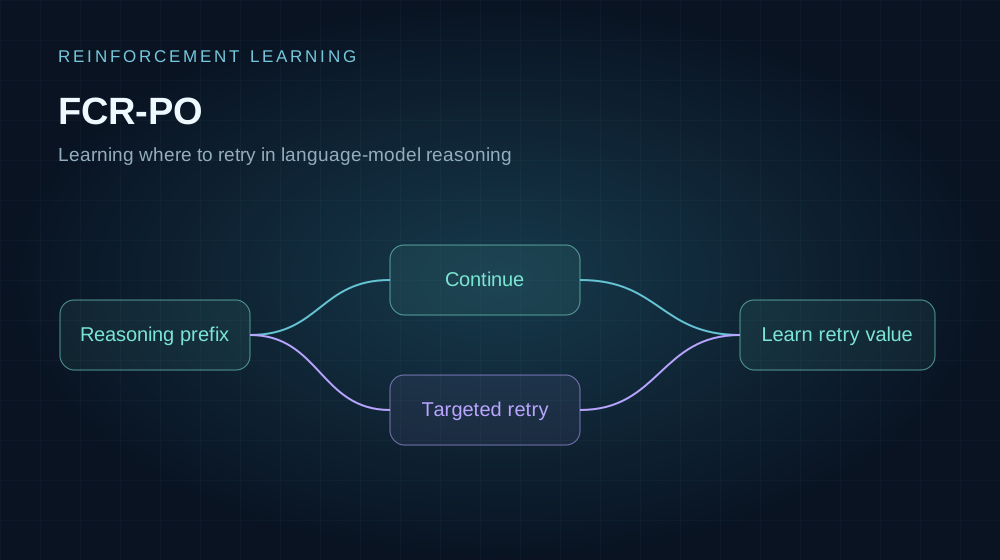
通过比较定向干预与普通续写,学习推理步骤的重试价值,研究有限训练预算下的探索与信用分配。ACML 2026 已接收。
2026 年 1–7 月ACML 2026 · 已接收第一作者 / 研究负责人
Reinforcement LearningLLM ReasoningCredit Assignment
研究概览
通过比较定向干预与普通续写,学习推理步骤的重试价值,研究有限训练预算下的探索与信用分配。ACML 2026 已接收。
工作关注“哪些决策值得学习”,而不仅是增加重试或重放的数量。详细方法与实验范围以论文和最新 CV 为准。